Stage de fin d'études — Consultant Data & Intelligence Artificielle chez Saegus
Un outil IA pour scorer automatiquement la compatibilité entre un CV et une offre d'emploi.
Contexte du projet :
Chez Saegus, les équipes RH reçoivent chaque jour jusqu'à une centaine de candidatures, rendant le tri manuel chronophage, peu objectif et propice à la perte de bons profils. Après avoir étudié les solutions du marché (Manatal, TeamTailor Co-pilot, Eightfold AI, HireEZ), leur adoption s'est révélée coûteuse et peu compatible avec l'ATS déjà utilisé par l'entreprise, TeamTailor. Nous avons donc fait le choix de développer notre propre outil : CV Compatibility, un projet interne visant à automatiser le screening des candidatures en calculant, pour chaque candidat, un score de compatibilité avec une offre donnée, tout en justifiant ce résultat aux recruteurs.
Récupération des données
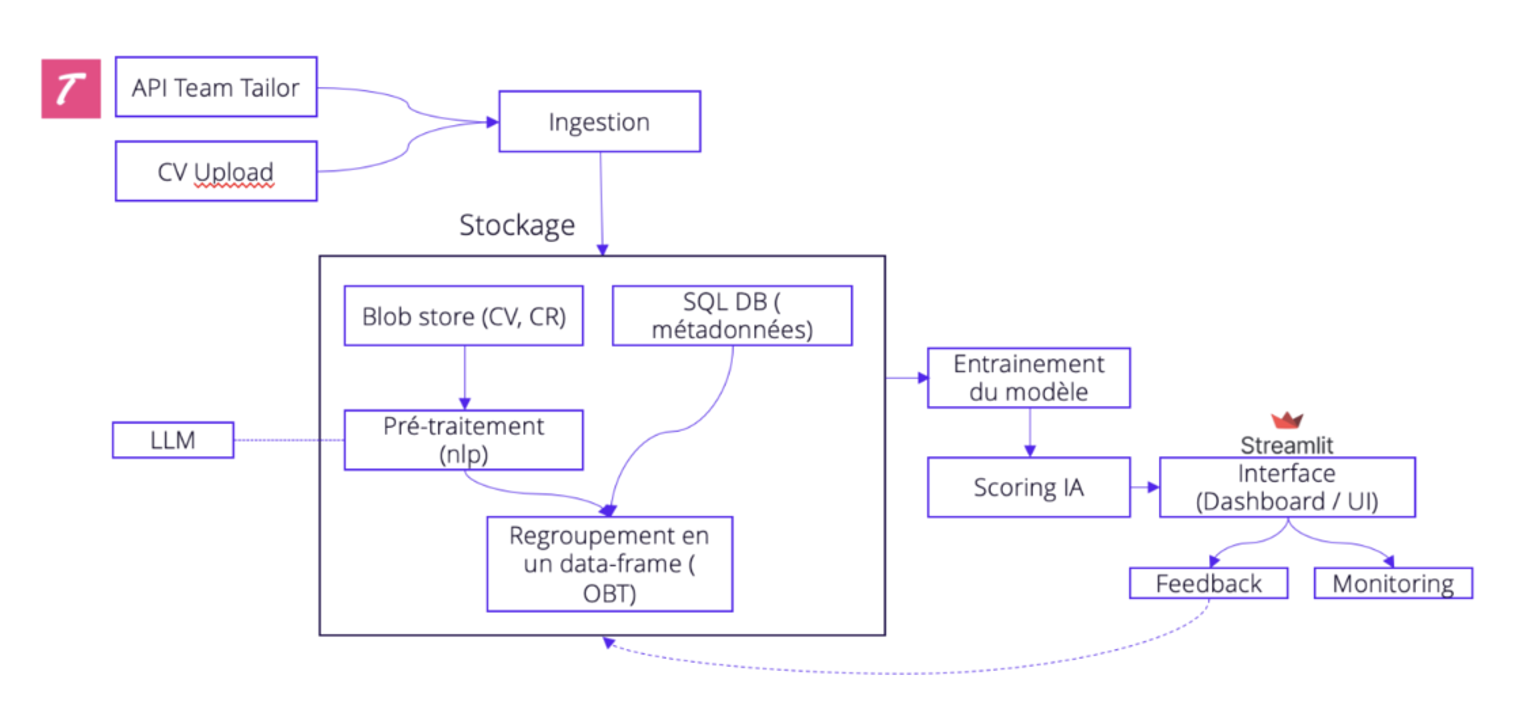
Les données proviennent de l'API de TeamTailor, l'ATS utilisé par les RH de Saegus, puis sont stockées dans un Blob Storage Azure (CV, comptes rendus, métadonnées). Un LLM est utilisé pour aider à la segmentation des CV, garantissant un traitement fiable même sur des CV incomplets ou aux structures hétérogènes, et pour enrichir les données (ex. : détection des fautes d'orthographe).
Pipeline de nettoyage (architecture Médaillon)
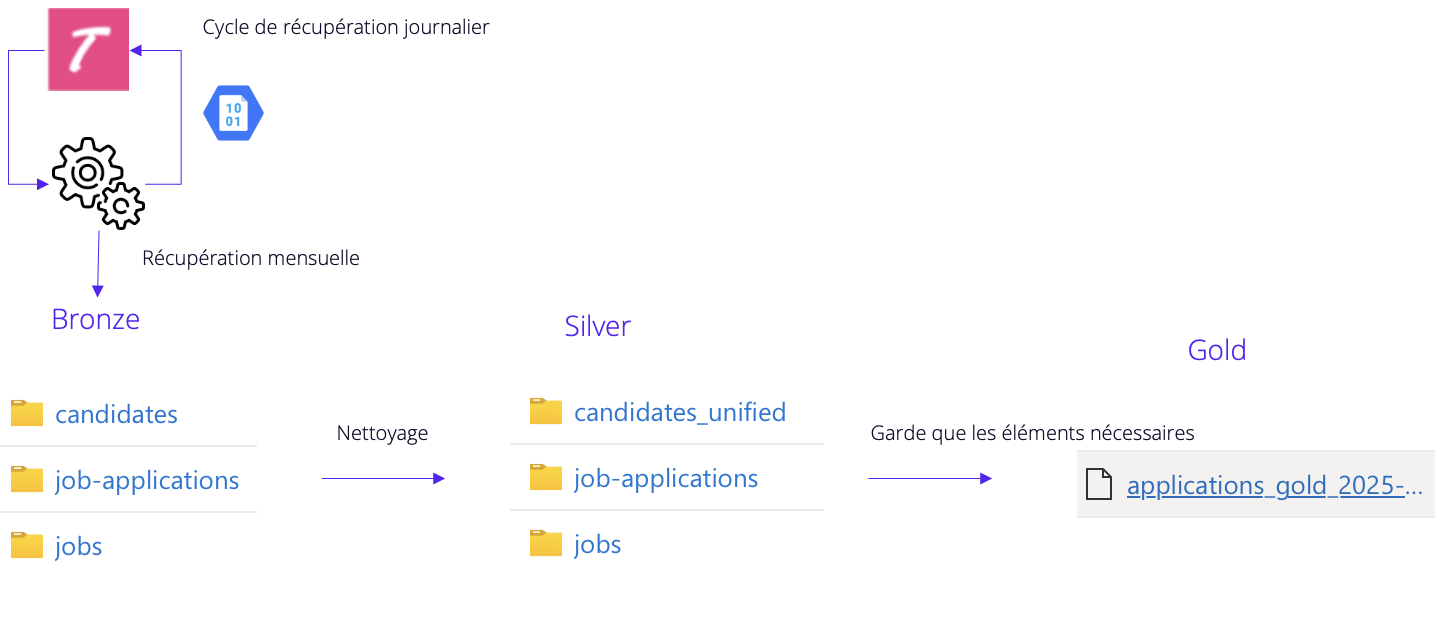
Les données brutes traversent trois couches successives : Bronze (ingestion telle quelle depuis l'API), Silver (nettoyage, suppression des doublons, jointures entre tables) et Gold (table métier finale, prête pour l'entraînement du modèle et pour les tableaux de bord). Cette approche garantit une traçabilité complète et sépare clairement la pipeline de données de celle du machine learning.
Modélisation avec XGBoost
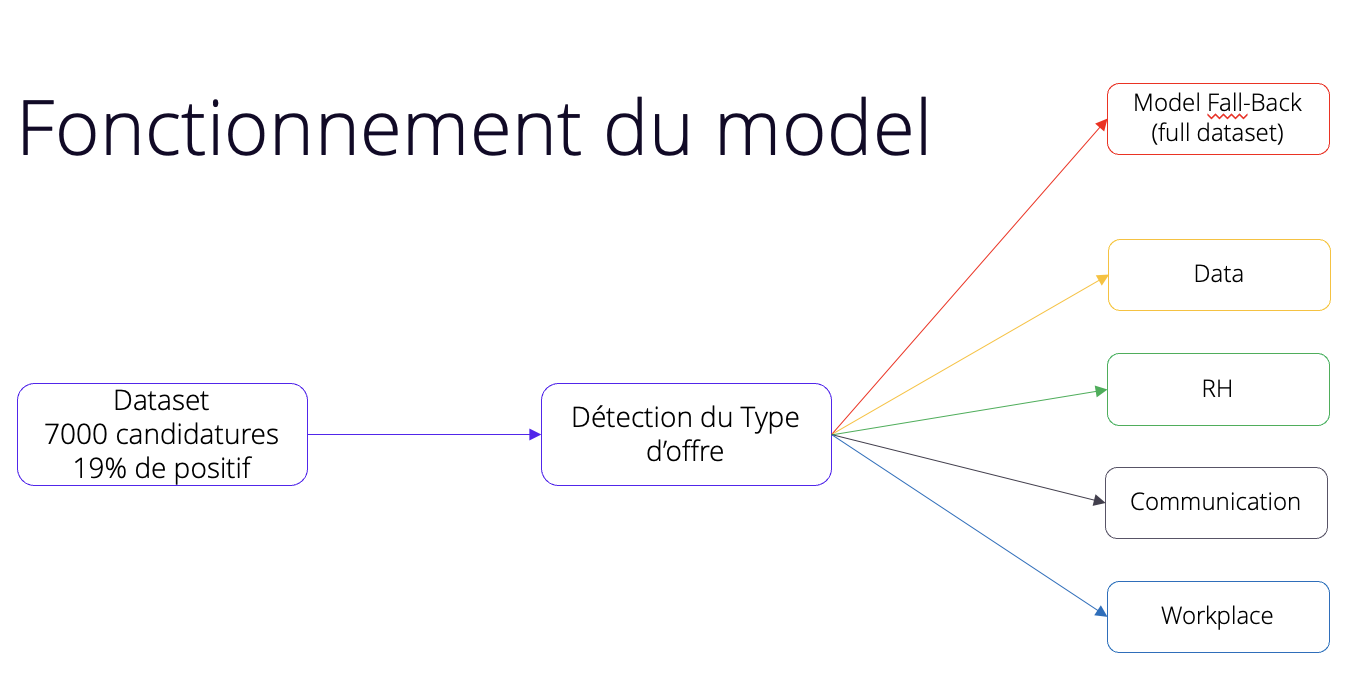
Le modèle repose sur XGBoost (gradient boosting), choisi pour sa robustesse sur données tabulaires hétérogènes (numériques, textuelles, embeddings), son interprétabilité (feature importance, SHAP) et sa gestion native du déséquilibre des classes. Un modèle spécialisé est entraîné par Business Unit (Data, RH, Communication, Workplace, Factory), complété par un modèle fallback ; un model selector choisit automatiquement le modèle le plus adapté pour chaque candidature.
Feature engineering
La qualité des variables construites conditionne directement la performance du modèle. Le feature engineering s'articule autour de six familles : les compétences (hard et soft skills, matching exact et par synonymes), les langues requises par l'offre, la couverture des exigences du poste par le CV, l'expérience professionnelle (années cumulées vs seuil requis), la formation (détection d'écoles cibles) et la similarité sémantique entre CV et offre, calculée via des embeddings denses (modèle multilingual-E5-Base).
Résultats
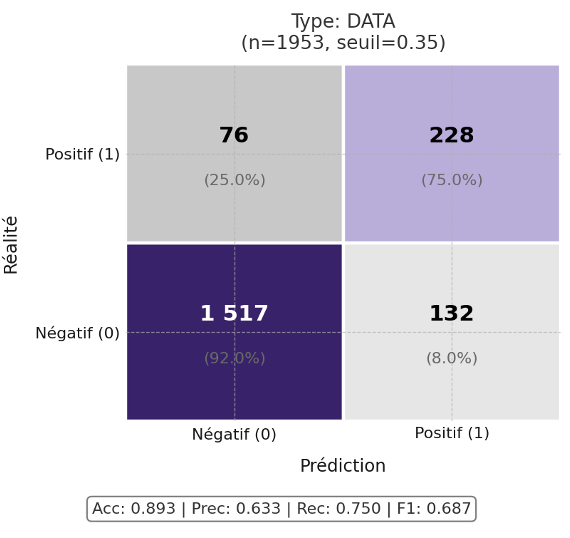
Le modèle atteint un ROC-AUC de 0.81 et une PR-AUC de 0.48, avec une précision de 0.633 et un recall de 0.750 sur la classe positive. Il conserve surtout un taux de 92 % de vrais négatifs, ce qui signifie qu'il laisse très rarement passer un mauvais candidat — un résultat particulièrement recherché pour un premier niveau de screening. La qualité du classement (nDCG@K) confirme par ailleurs que les meilleurs profils remontent bien en tête de liste, ce qui est l'usage réel attendu par les RH.
Interface Streamlit
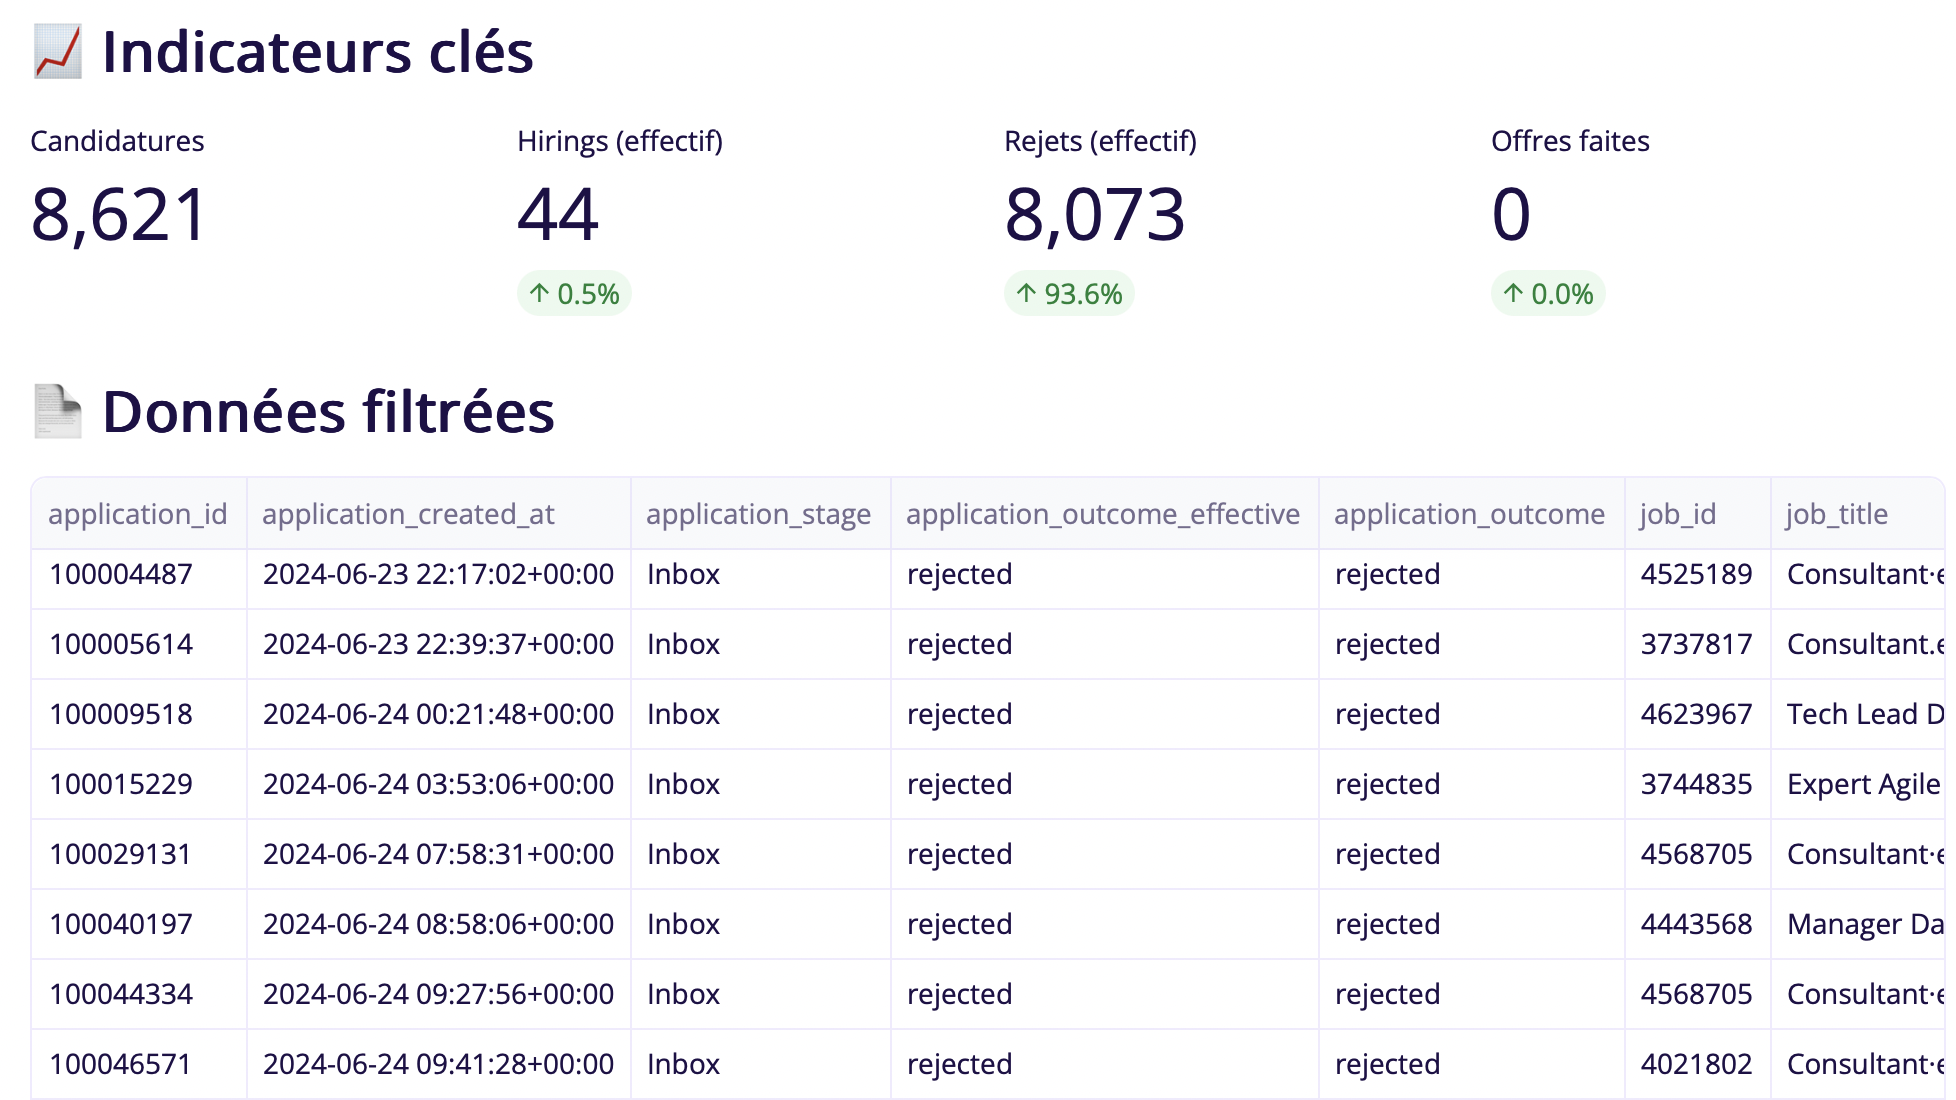
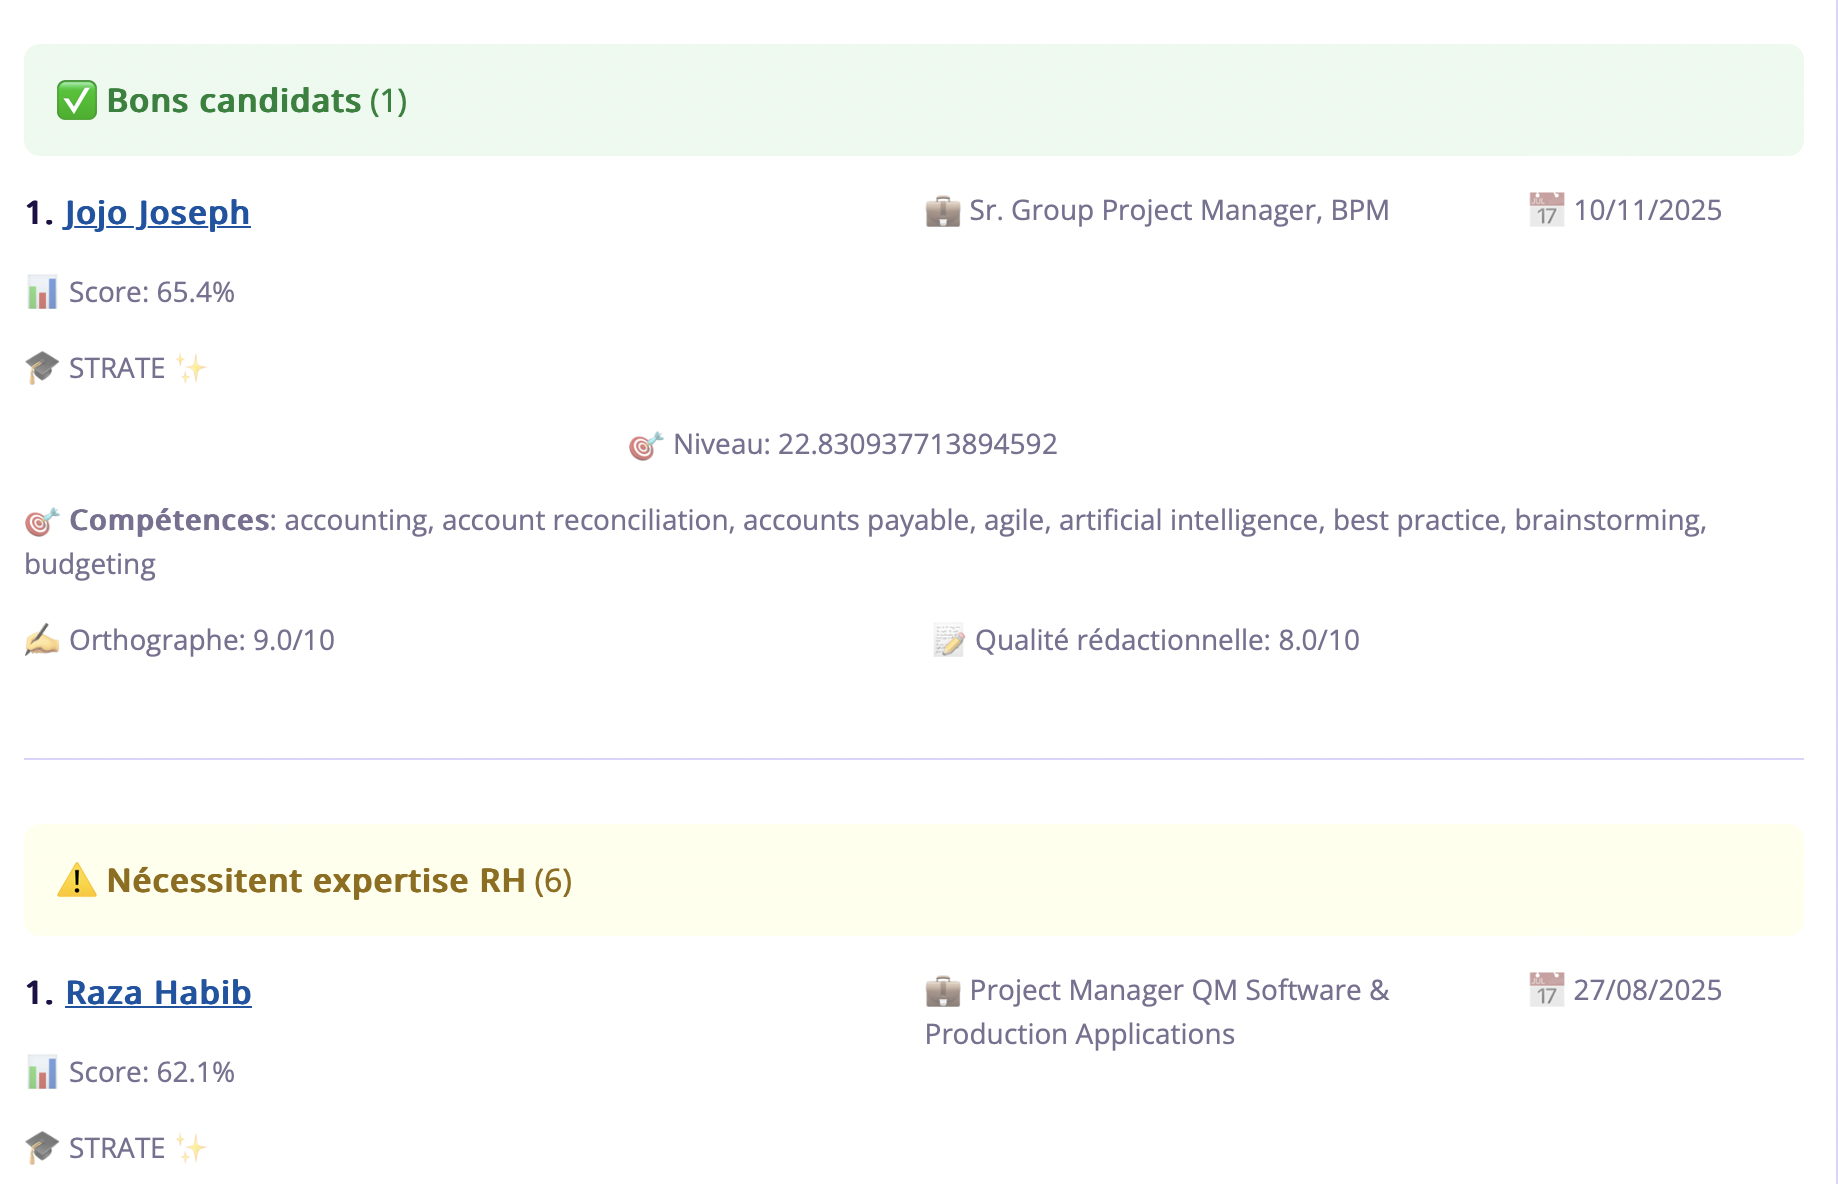
L'application Streamlit constitue l'interface principale du projet pour les équipes RH : visualisation des offres actives et de leurs indicateurs, consultation des candidats non traités, puis scoring automatique des candidatures d'un simple clic.
Perspectives
Le taux de faux négatifs (25 %) reste le principal axe d'amélioration, notamment via l'ajustement des seuils, le rééchantillonnage ou une meilleure calibration. Les pistes envisagées incluent la mise en place d'une boucle de feedback RH pour affiner continuellement le modèle, l'exploitation de modèles multimodaux combinant texte et structure du CV, ainsi que le fine-tuning d'un LLM spécialisé pour améliorer l'extraction des compétences et l'alignement sémantique.